


03 Nov एआई प्रशिक्षण मॉडल से निजता के अधिकार का हनन
✎ निजता अनुच्छेद 21 के अंतर्गत मौलिक अधिकार है (पुट्टस्वामी, 2017), और एआई मॉडल द्वारा प्रशिक्षण-आँकड़ों को कंठस्थ कर लेने से अनामीकृत आँकड़ों के बावजूद पहचान का जोखिम बना रहता है, जिसका नियमन DPDP Act, 2023 के चरणबद्ध क्रियान्वयन…
विषय प्रासंगिकता — यह टॉपिक कहाँ आता है
- GS Paper II — राजव्यवस्था (Polity): मौलिक अधिकार, अनुच्छेद 21 और निजता का अधिकार; सरकारी नीतियाँ और विधि-निर्माण | GS Paper III — विज्ञान एवं प्रौद्योगिकी (Science and Technology): कृत्रिम बुद्धिमत्ता (Artificial Intelligence) के नैतिक व सामाजिक प्रभाव; साइबर सुरक्षा (Cyber Security)
- Prelims: निजता का अधिकार (Right to Privacy) और अनुच्छेद 21, डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 (DPDP Act, 2023), डेटा प्रधान (Data Principal) और डेटा न्यासी (Data Fiduciary), डेटा संरक्षण बोर्ड (Data Protection Board of India), सूचना प्रौद्योगिकी अधिनियम, 2000 की धारा 43A और 72A, संवेदनशील व्यक्तिगत आँकड़े (SPDI) नियम, 2011, विमोचन-आधारित हमले: मॉडल व्युत्क्रमण (Model Inversion) और सदस्यता अनुमान (Membership Inference), अनामीकरण (Anonymisation) और छद्मनामीकरण (Pseudonymisation) में अंतर
- Essay: तकनीकी प्रगति और निजता: नवाचार को रोके बिना अधिकारों की रक्षा कैसे हो?, कृत्रिम बुद्धिमत्ता के युग में विधि का समयोचित होना: कठोर नियमन बनाम लचीला शासन
त्वरित पुनरावृत्ति: निजता अनुच्छेद 21 के अंतर्गत मौलिक अधिकार है (पुट्टस्वामी, 2017), और एआई मॉडल द्वारा प्रशिक्षण-आँकड़ों को कंठस्थ कर लेने से अनामीकृत आँकड़ों के बावजूद पहचान का जोखिम बना रहता है, जिसका नियमन DPDP Act, 2023 के चरणबद्ध क्रियान्वयन से जुड़ा है।
यह खबर चर्चा में क्यों?
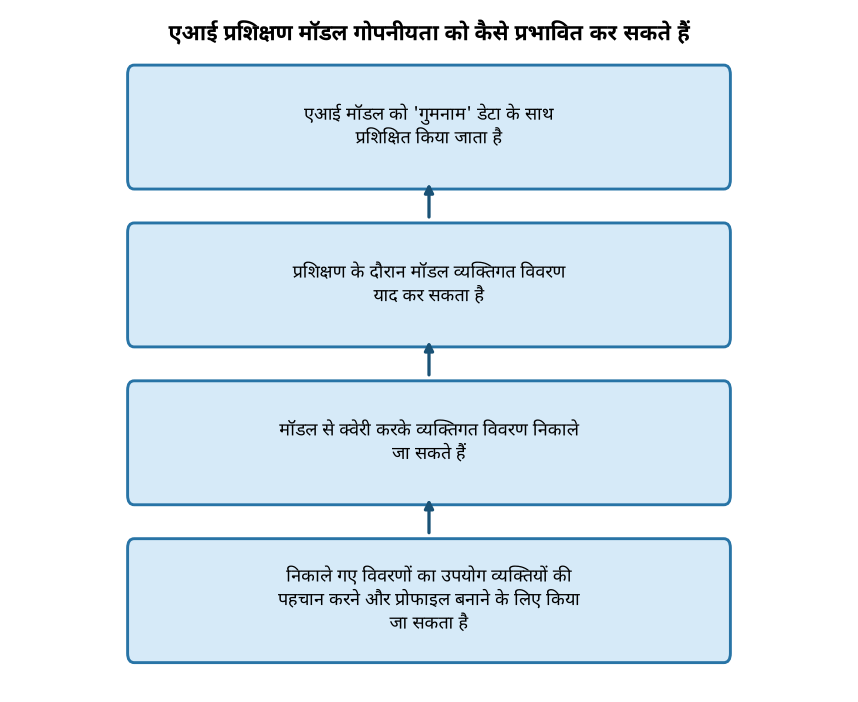
हाल के विश्वसनीय अध्ययनों से पता चला है कि किसी एआई मॉडल से ‘अनामीकृत’ (anonymised) आँकड़ों के आधार पर ऐसी पूछताछ की जा सकती है, जिससे वह प्रशिक्षण के दौरान याद किए गए व्यक्तिगत विवरण उगल दे। इन विवरणों के आधार पर व्यक्तियों की पहचान और उनकी प्रोफ़ाइल तैयार की जा सकती है। लेख के अनुसार, निजता का अधिकार सर्वोच्च न्यायालय ने 2017 में संवैधानिक अधिकार के रूप में मान्यता दिया था, परंतु वर्तमान विधिक उपाय इस नई चुनौती के लिए अपर्याप्त प्रतीत होते हैं। साथ ही, डिजिटल व्यक्तिगत डेटा संरक्षण नियम, 2025 नवंबर 2025 में अधिसूचित हुए हैं और इनके कुछ प्रावधान, जैसे सहमति और सुरक्षा से जुड़े उपबंध, 2027 में ही प्रभावी होंगे। इसी संदर्भ में यह बहस उभरी है कि एआई के नियमन को नवाचार और आर्थिक संवृद्धि को बाधित किए बिना कैसे लक्षित किया जाए।
पृष्ठभूमि
- पुट्टस्वामी बनाम भारत संघ (2017) में नौ-न्यायाधीशों की पीठ ने निजता को अनुच्छेद 21 के अंतर्गत जीवन और वैयक्तिक स्वतंत्रता का अंतर्निहित भाग माना। इस निर्णय में राज्य के हस्तक्षेप के लिए विधिकता, आवश्यकता और अनुपातिकता की कसौटी भी निर्धारित की गई।
- सूचना प्रौद्योगिकी अधिनियम, 2000 और उसके अंतर्गत 2011 के नियम (संवेदनशील व्यक्तिगत आँकड़े नियम) प्रमुख विधिक ढाँचा थे। इनके तहत वित्तीय, चिकित्सा, लैंगिक रुझान और बायोमेट्रिक जैसे संवेदनशील आँकड़ों के अप्राधिकृत प्रकटीकरण पर अधिकतम तीन वर्ष का कारावास या ₹5 लाख तक का जुर्माना था।
- पूर्ववर्ती ढाँचे की कमी यह थी कि नाम, पता, फ़ोन नंबर, जाति, धर्म, राजनीतिक संबद्धता, ब्राउज़िंग इतिहास और सोशल मीडिया गतिविधि जैसे आँकड़े उसके दायरे से बाहर थे, और डेटा निर्यात में ‘दावा मात्र’ पर्याप्त माना जाता था।
- डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 ने व्यक्तिगत आँकड़ों के प्रसंस्करण के लिए व्यापक ढाँचा दिया, और इसके नियम नवंबर 2025 में अधिसूचित हुए। इसका क्रियान्वयन चरणबद्ध है।
- एआई मॉडल प्रशिक्षण के दौरान विशाल आँकड़ा-समूह से सीखते हैं, और कुछ मामलों में वे मूल आँकड़ों के अंश ‘कंठस्थ’ कर लेते हैं। यही जोखिम का मूल कारण है, जिसे पारंपरिक अनामीकरण तकनीकें पूरी तरह नहीं रोक पातीं।
एआई प्रशिक्षण मॉडल में निजता जोखिम क्या है?
- बड़े भाषा मॉडल (Large Language Models) जैसे एआई प्रणालियाँ प्रशिक्षण-आँकड़ों से पैटर्न सीखती हैं, परंतु कई बार प्रशिक्षण-आँकड़ों के विशिष्ट अंश भी मॉडल के भीतर संचित रह जाते हैं। इसे अति-स्मरण (Memorisation) कहा जाता है।
- विमोचन-आधारित हमले (Extraction Attacks) में बाहरी व्यक्ति सावधानी से बनाए गए प्रश्नों के माध्यम से मॉडल से ये संचित विवरण निकलवा सकता है।
- सदस्यता अनुमान (Membership Inference) में यह पता लगाया जाता है कि कोई विशेष व्यक्ति या रिकॉर्ड प्रशिक्षण-आँकड़ों में शामिल था या नहीं, जिससे गोपनीयता भंग हो सकती है।
- अनामीकरण (Anonymisation) में पहचान-चिह्न हटाए जाते हैं, जबकि छद्मनामीकरण (Pseudonymisation) में पहचान को कूट-चिह्न से बदला जाता है। आँकड़ों को संयोजित करने पर पुनः पहचान संभव होने से अनामीकरण की सीमाएँ स्पष्ट होती हैं।
- डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 में डेटा प्रधान वह व्यक्ति है जिसके आँकड़े हैं, और डेटा न्यासी वह संस्था है जो प्रसंस्करण का उद्देश्य और साधन तय करती है। सहमति, उद्देश्य-सीमा और आँकड़ा-न्यूनीकरण इसके मूल सिद्धांत हैं।
- इस अधिनियम के अंतर्गत डेटा संरक्षण बोर्ड (Data Protection Board of India) शिकायतों की सुनवाई और दंड अधिरोपण का कार्य करता है। सुरक्षा उपायों की विफलता पर अधिकतम ₹250 करोड़ तक का शास्ति (Penalty) का प्रावधान है।
- नीतिगत चुनौती यह है कि एआई पर व्यापक, अस्पष्ट नियम नवाचार को बाधित कर सकते हैं, इसलिए लक्षित और स्पष्ट विधिक अंतराल भरने पर बल दिया जाता है।
मुख्य विशेषताएँ
| विशेषता | महत्व |
|---|---|
| मुख्य जोखिम | AI मॉडल प्रशिक्षण के दौरान व्यक्तिगत डेटा का स्मरणीकरण (Memorisation) कर लेता है। अनामीकृत (Anonymised) डेटा से भी व्यक्ति की पुनः पहचान (Re-identification) और प्रोफ़ाइल निर्माण संभव है। |
| संवैधानिक आधार | निजता का अधिकार अनुच्छेद 21 के अंतर्गत जीवन और व्यक्तिगत स्वतंत्रता का अभिन्न अंग है। सर्वोच्च न्यायालय ने 2017 के पुट्टस्वामी निर्णय में इसे मौलिक अधिकार के रूप में स्थापित किया। |
| वर्तमान विधिक ढाँचा | डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 (Digital Personal Data Protection Act, 2023) मुख्य विधि है। इसके नियम नवंबर 2025 में अधिसूचित हुए और प्रावधान चरणबद्ध ढंग से लागू हो रहे हैं, जिनमें सहमति से जुड़े प्रावधान 2027 से प्रभावी होंगे। |
| पूर्ववर्ती व्यवस्था | सूचना प्रौद्योगिकी अधिनियम, 2000 (Information Technology Act, 2000) और 2011 के नियम संवेदनशील व्यक्तिगत डेटा के निर्यात को नियंत्रित करते थे। पर्याप्त संरक्षण का आकलन केवल घोषणा और दावे के आधार पर हो सकता था। |
| दंड प्रावधान | अनधिकृत प्रकटीकरण पर सूचना प्रौद्योगिकी अधिनियम की धारा 72A के अंतर्गत अधिकतम तीन वर्ष का कारावास या ₹5 लाख तक का जुर्माना था। |
| नियामक दायरे से बाहर डेटा | नाम, पता, फ़ोन नंबर, जाति, धर्म, राजनीतिक संबद्धता, ब्राउज़िंग इतिहास और सोशल मीडिया गतिविधि 2011 के नियमों के दायरे में नहीं आते थे। |
महत्व
संवैधानिक एवं विधिक
- निजता के अधिकार को व्यवहार में प्रभावी बनाना अनुच्छेद 21 की व्याख्या के अनुरूप है।
- AI से उत्पन्न जोखिम यह दर्शाते हैं कि विधि को तकनीकी विकास के साथ अद्यतन रखना आवश्यक है।
- DPDP अधिनियम 2023 पूर्ववर्ती IT अधिनियम की सीमाओं को दूर करने का प्रयास है।
आर्थिक
- AI में उत्पादकता और आर्थिक संवृद्धि की अपार संभावनाएँ हैं, इसलिए नियमन ऐसा हो जो नवाचार को अनावश्यक रूप से बाधित न करे।
- विश्वसनीय डेटा संरक्षण व्यवस्था डिजिटल सेवाओं में नागरिकों का भरोसा बढ़ाती है, जो दीर्घकालिक आर्थिक हित में है।
प्रशासनिक एवं नियामकीय
- विशिष्ट अंतरालों की पहचान कर लक्षित संशोधन करना, व्यापक और अस्पष्ट नीतियों की तुलना में अधिक व्यावहारिक है।
- सहमति, सुरक्षा और दंड से जुड़े प्रावधानों का चरणबद्ध कार्यान्वयन नियामक क्षमता के निर्माण का अवसर देता है।
चुनौतियाँ
1. अनामीकरण की सीमा
- अनामीकृत डेटा को क्वेरी के माध्यम से पुनः पहचाना जा सकता है, इसलिए नाम हटाना अपने-आप में पर्याप्त सुरक्षा नहीं है।
- मॉडल से व्यक्तिगत विवरण निकालने की प्रक्रिया (Model Inversion) और सदस्यता अनुमान (Membership Inference) जैसी तकनीकें जोखिम बढ़ाती हैं।
यूपीएससी लिंक: विज्ञान एवं प्रौद्योगिकी: डेटा सुरक्षा और AI के नैतिक पक्ष
2. पुराने विधिक प्रावधानों की अपर्याप्तता
- IT अधिनियम, 2011 के नियम केवल कुछ संवेदनशील श्रेणियों तक सीमित थे, जबकि AI प्रशिक्षण में सामान्य व्यवहारिक और संस्थागत डेटा भी उपयोग होता है।
- पर्याप्त संरक्षण का आकलन केवल घोषणा के आधार पर होना प्रवर्तन को कमजोर करता है।
यूपीएससी लिंक: शासन: विधि निर्माण और नियामक ढाँचे की प्रभावशीलता
3. AI विनियमन की अस्पष्टता
- AI विनियमन से संबंधित सिफारिशें अक्सर व्यापक और अस्पष्ट रहती हैं, जिससे नीतिगत स्पष्टता नहीं बनती।
- सीमित और विशिष्ट उपायों की पहचान न होने से नियामक निश्चितता और अनुपालन दोनों प्रभावित होते हैं।
यूपीएससी लिंक: शासन: नीति निर्माण और विनियामक संस्थाएँ
4. नवाचार और संरक्षण के बीच संतुलन
- अत्यधिक या असंगत नियमन स्टार्टअप और शोध को सीमित कर सकता है।
- निजता की रक्षा और आर्थिक संवृद्धि के बीच संतुलन उचित प्रतिबंधों के सिद्धांत से तय होता है।
यूपीएससी लिंक: अर्थव्यवस्था: आर्थिक संवृद्धि और नियमन का संबंध
5. चरणबद्ध कार्यान्वयन का अंतराल
- कई प्रावधान 2027 तक प्रभावी नहीं होंगे, जिससे इस अवधि में संरक्षण में खामियाँ बनी रह सकती हैं।
- नियमों की अधिसूचना और वास्तविक प्रवर्तन के बीच समय का अंतर जागरूकता और क्षमता निर्माण की चुनौती है।
यूपीएससी लिंक: शासन: कानून का कार्यान्वयन और प्रशासनिक क्षमता
चुनौतियाँ — यूपीएससी दृष्टिकोण
| समस्या | चिंता |
|---|---|
| पुनः पहचान का जोखिम | अनामीकृत डेटा से AI मॉडल के माध्यम से व्यक्तियों की पहचान और प्रोफ़ाइल निर्माण संभव है। |
| सहमति का स्वरूप | AI प्रशिक्षण में डेटा के उपयोग की सूचित सहमति प्राप्त करना व्यावहारिक रूप से कठिन है। |
| दंड की सीमा | पुराने दंड प्रावधान सीमित श्रेणी के डेटा पर लागू होते थे और उनका निवारक प्रभाव सीमित था। |
| नियामक स्पष्टता | व्यापक सिफारिशें नीतिगत दिशा स्पष्ट नहीं करतीं, जिससे अनुपालन में भ्रम रहता है। |
| कार्यान्वयन में विलंब | 2027 तक कुछ प्रावधानों के प्रभावी न होने से संक्रमण काल में सुरक्षा अपूर्ण रहती है। |
आगे की राह
- AI प्रशिक्षण में प्रयुक्त डेटा के लिए केवल नाम हटाने के बजाय जोखिम-आधारित अनामीकरण मानक अपनाए जाएँ।
- मॉडल के स्मरणीकरण और पुनः पहचान जोखिम के परीक्षण को अनिवार्य अनुपालन प्रक्रिया का हिस्सा बनाया जाए।
- DPDP अधिनियम के अंतर्गत डेटा न्यासी (Data Fiduciary) के दायित्व और सहमति प्रक्रिया को AI संदर्भ में स्पष्ट दिशानिर्देशों से जोड़ा जाए।
- डेटा संरक्षण बोर्ड (Data Protection Board of India) की नियामक क्षमता और प्रवर्तन तंत्र को समय पर सुदृढ़ किया जाए।
- चरणबद्ध कार्यान्वयन की अवधि में अंतरिम दिशानिर्देश जारी कर संरक्षण के अंतराल को कम किया जाए।
- नवाचार और निजता के बीच संतुलन हेतु नियमन को लक्षित और आनुपातिक रखा जाए, ताकि व्यापक प्रतिबंध से बचा जा सके।
- नागरिकों में डेटा अधिकारों और शिकायत निवारण की जानकारी बढ़ाई जाए।
यूपीएससी मूल्य-संवर्धन
मुख्य परीक्षा उत्तर-लेखन हेतु कीवर्ड
निजता का अधिकार (Right to Privacy) · अनुच्छेद 21 और पुट्टस्वामी निर्णय (2017) · कृत्रिम बुद्धिमत्ता (Artificial Intelligence) और डेटा स्मरण (Data Memorisation) · अनामीकरण (Anonymisation) की सीमाएँ और पुनः पहचान (Re-identification) का जोखिम · डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 (Digital Personal Data Protection Act, 2023) · डेटा प्रिंसिपल और डेटा फिड्यूशरी (Data Principal and Data Fiduciary) · डेटा संरक्षण बोर्ड (Data Protection Board of India) · संवेदनशील व्यक्तिगत डेटा और सूचना प्रौद्योगिकी अधिनियम, 2000 की धारा 43A व 72A · उद्देश्य सीमितता, डेटा न्यूनीकरण और सहमति (Purpose Limitation, Data Minimisation and Consent) · सीमा-पार डेटा अंतरण (Cross-border Data Transfer) · नवाचार बनाम विनियमन का संतुलन · यूरोपीय संघ का सामान्य डेटा संरक्षण विनियमन (GDPR) और AI अधिनियम
संवैधानिक व नीतिगत संबंध
- अनुच्छेद 21: निजता का अधिकार, पुट्टस्वामी निर्णय से स्थापित
- अनुच्छेद 19(1)(g): AI व्यवसाय और नवाचार की स्वतंत्रता; उचित प्रतिबंध आवश्यक
अवधारणा प्रवाह
AI मॉडल बड़े डेटासेट पर प्रशिक्षित होता है और उसमें व्यक्तिगत विवरण स्मरणीकृत हो सकते हैं। → अनामीकृत डेटा पर क्वेरी द्वारा इन विवरणों को निकालकर व्यक्तियों की पुनः पहचान की जा सकती है। → पुनः पहचान से प्रोफ़ाइल निर्माण होता है, जो निजता के अधिकार (अनुच्छेद 21) का उल्लंघन है। → पूर्ववर्ती IT अधिनियम, 2000 और 2011 के नियम सीमित श्रेणियों तक संरक्षण देते थे, इसलिए अंतराल बना रहा। → DPDP अधिनियम, 2023 और नवंबर 2025 के नियम इस अंतराल को भरने का प्रयास करते हैं, पर कई प्रावधान 2027 से प्रभावी होंगे। → लक्षित विनियमन, प्रवर्तन क्षमता और नवाचार के संतुलन से AI युग में निजता की व्यावहारिक सुरक्षा सुनिश्चित होती है।
प्रारंभिक अभ्यास प्रश्न
Q1. निम्नलिखित कथनों पर विचार कीजिए:
1. डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 में ‘डेटा प्रिंसिपल’ से आशय उस व्यक्ति से है जिससे संबंधित व्यक्तिगत डेटा है।
2. डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 के अंतर्गत डेटा संरक्षण बोर्ड की स्थापना का प्रावधान है।
3. ऐसा व्यक्तिगत डेटा, जिसे डेटा प्रिंसिपल ने स्वयं सार्वजनिक रूप से उपलब्ध कराया हो, इस अधिनियम के दायरे से बाहर रखा गया है।
4. पुट्टस्वामी निर्णय (2017) में सर्वोच्च न्यायालय ने निजता के अधिकार को केवल अनुच्छेद 19 के अंतर्गत माना था, अनुच्छेद 21 के अंतर्गत नहीं।
उपर्युक्त में से कितने कथन सही हैं?
- केवल एक
- केवल दो
- केवल तीन
- सभी चार
उत्तर: केवल तीन — कथन 1 सही है: ‘डेटा प्रिंसिपल’ वह व्यक्ति है जिससे व्यक्तिगत डेटा संबंधित है। कथन 2 सही है: अधिनियम की धारा 18 के तहत डेटा संरक्षण बोर्ड की स्थापना होती है। कथन 3 सही है: धारा 3(c)(ii) के अनुसार स्वयं डेटा प्रिंसिपल द्वारा सार्वजनिक किया गया डेटा अधिनियम से बाहर है। कथन 4 गलत है: पुट्टस्वामी निर्णय में निजता को अनुच्छेद 21 (जीवन और व्यक्तिगत स्वतंत्रता) का अभिन्न अंग माना गया है।
Q2. निम्नलिखित पर विचार कीजिए:
अभिकथन (A): कृत्रिम बुद्धिमत्ता मॉडल को प्रशिक्षण में प्रयुक्त ‘अनामीकृत’ डेटा के साथ क्वेरी करने पर भी उसमें स्मरण किए गए व्यक्तिगत विवरण प्रकट हो सकते हैं।
कारण (R): प्रशिक्षण के दौरान मॉडल प्रशिक्षण डेटा के कुछ भागों को स्मरण कर लेते हैं, जिन्हें उचित क्वेरी द्वारा निकाला जा सकता है।
नीचे दिए गए विकल्पों में से सही उत्तर चुनिए:
- (a) A और R दोनों सही हैं और R, A की सही व्याख्या है।
- (b) A और R दोनों सही हैं, किंतु R, A की सही व्याख्या नहीं है।
- (c) A सही है, किंतु R गलत है।
- (d) A गलत है, किंतु R सही है।
उत्तर: (a) A और R दोनों सही हैं और R, A की सही व्याख्या है। — अभिकथन और कारण दोनों सही हैं। अनामीकरण से केवल प्रत्यक्ष पहचानकर्ता हटते हैं; मॉडल में स्मरित पैटर्न से अप्रत्यक्ष पहचान संभव रहती है। यही कारण अभिकथन की व्याख्या करता है, इसलिए (a) सही है।
Q3. सूचना प्रौद्योगिकी अधिनियम, 2000 की कौन-सी धारा किसी मध्यस्थ या सेवा प्रदाता द्वारा वैध संविदा का उल्लंघन करते हुए किसी व्यक्ति से संबंधित सूचना के प्रकटीकरण पर दंड का प्रावधान करती है, जिसमें अधिकतम तीन वर्ष का कारावास या ₹5 लाख तक का जुर्माना हो सकता है?
- धारा 66A
- धारा 72A
- धारा 67
- धारा 69
उत्तर: धारा 72A — धारा 72A वैध संविदा के उल्लंघन में सूचना के प्रकटीकरण पर दंड निर्धारित करती है, जिसमें तीन वर्ष तक का कारावास या ₹5 लाख तक का जुर्माना हो सकता है। धारा 66A को सर्वोच्च न्यायालय ने श्रेया सिंघल मामले (2015) में असंवैधानिक ठहराया था। धारा 67 अश्लील सामग्री से, और धारा 69 सरकारी निगरानी/अवरोधन से संबंधित है।
मुख्य अभ्यास प्रश्न
✍ कृत्रिम बुद्धिमत्ता प्रशिक्षण मॉडलों में व्यक्तिगत डेटा के स्मरण की प्रवृत्ति के कारण ‘अनामीकृत’ डेटा भी पुनः पहचान का स्रोत बन सकता है, जिससे निजता के अधिकार पर गंभीर चुनौती उत्पन्न होती है। इस संदर्भ में डिजिटल व्यक्तिगत डेटा संरक्षण अधिनियम, 2023 और उसके नियमों की पर्याप्तता की समालोचनात्मक परीक्षा कीजिए। साथ ही उत्तर दीजिए कि यदि अनामीकरण को सुरक्षा का पर्याप्त उपाय न माना जाए, तो विधि-निर्माण के समक्ष कौन-से विकल्प और उनकी सीमाएँ सामने आती हैं। (15 Marks)
रूपरेखा: मॉडल-उत्तर संरचना (कुल बिंदु):
1. भूमिका: पुट्टस्वामी बनाम भारत संघ (2017) में नौ-न्यायाधीशों की पीठ ने निजता को अनुच्छेद 21 का अभिन्न अंग माना। न्यायालय ने राज्य के हस्तक्षेप के लिए वैधता, वैध उद्देश्य और आनुपातिकता की कसौटी दी। इसे AI के संदर्भ में लागू करना उत्तर का आधार है।
2. तकनीकी आयाम: बड़े भाषा मॉडल प्रशिक्षण डेटा के कुछ भाग स्मरण कर सकते हैं। सदस्यता अनुमान हमला (Membership Inference Attack) और मॉडल व्युत्क्रमण (Model Inversion) से यह पता लगाया जा सकता है कि कोई व्यक्ति प्रशिक्षण डेटा में था या नहीं, तथा विवरण निकाले जा सकते हैं। अनामीकरण केवल प्रत्यक्ष पहचानकर्ता हटाता है; संयोजन से पुनः पहचान संभव है। इसलिए ‘अनामीकृत’ शब्द पर्याप्त सुरक्षा नहीं देता।
3. पूर्ववर्ती विधिक ढाँचा: सूचना प्रौद्योगिकी अधिनियम, 2000 की धारा 43A और धारा 72A तथा 2011 के संवेदनशील व्यक्तिगत डेटा नियम। सीमाएँ: संवेदनशील डेटा की सूची सीमित थी; नाम, पता, जाति, धर्म, ब्राउज़िंग इतिहास और व्यवहारगत डेटा इसके दायरे से बाहर थे; दंड अधिकतम तीन वर्ष या ₹5 लाख तक सीमित था।
4. डीपीडीपी अधिनियम, 2023 के प्रावधान: डेटा प्रिंसिपल के अधिकार, डेटा फिड्यूशरी के दायित्व (धारा 8), सहमति आधारित प्रसंस्करण, डेटा मिटाने का अधिकार (धारा 12), सीमा-पार अंतरण (धारा 16), सार्थक डेटा फिड्यूशरी (धारा 10) और डेटा संरक्षण बोर्ड। नियम नवंबर 2025 में अधिसूचित हुए; कुछ प्रावधान 2027 में प्रभावी होंगे।
5. आलोचनात्मक बिंदु: (क) धारा 3(c)(ii) के अंतर्गत सार्वजनिक रूप से उपलब्ध डेटा की छूट से AI प्रशिक्षण में बड़ा रास्ता खुलता है; (ख) धारा 17 के तहत शोध और सांख्यिकीय प्रयोजनों के लिए छूट का दुरुपयोग संभव है; (គ) मॉडल-स्तर पर स्मरण का नियमन अधिनियम में स्पष्ट नहीं है; (घ) बोर्ड की स्वतंत्रता और क्षमता पर प्रश्न।
6. संतुलन और नवाचार: न्यूनतम अनुपालन-भार बनाम सुरक्षा। कठोर नियम स्टार्टअप्स पर भारी पड़ सकते हैं। विकल्प: प्रशिक्षण-पूर्व डेटा न्यूनीकरण, डिज़ाइन द्वारा गोपनीयता (Privacy by Design), मॉडल ऑडिट, विभेदक गोपनीयता (Differential Privacy) जैसी तकनीकी उपाय, और उद्देश्य-आधारित प्रमाणन।
7. तुलनात्मक संदर्भ: यूरोपीय संघ का GDPR (अनुच्छेद 5 के सिद्धांत) और EU AI Act (2024) से तुलना, जिसमें जोखिम-आधारित वर्गीकरण है।
8. निष्कर्ष: भारत का ढाँचा सहमति और अधिकार-केंद्रित है, किंतु AI-विशिष्ट जोखिमों के लिए उपनियम, तकनीकी मानक और स्वतंत्र ऑडिट आवश्यक हैं ताकि संविधान प्रदत्त निजता और आर्थिक संवृद्धि दोनों सुरक्षित रहें।
स्रोत: The Hindu
शैक्षिक उद्देश्य हेतु AanyaAi द्वारा जनित।

- NAMASTE Scheme: Enhancing Sanitation Workers’ Livelihoods & Safety - November 14, 2026
- एमएसएमई का विशेष अभियान 6.0: स्वच्छता और लंबित मामलों का निपटारा - November 14, 2026
- Sea Vigil-26: Coastal Defence Drills Off Visakhapatnam - November 14, 2026

No Comments